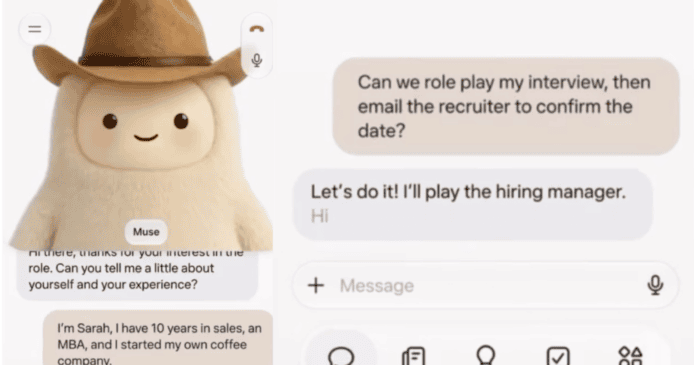
Meta 於 11 月 5 日宣布,旗下個人 AI 助理 Muse 推出 Muse Voice,讓用戶以語音通話或全螢幕虛擬角色介面與 AI 即時交流。據 Meta 官方公告,用戶可以在 AI 回答途中直接插話,角色亦會配合對話改變表情與動作;功能首先向美國用戶開放,支援手機、網頁及 Mac。
AI 虛擬角色跟住對話做表情及動作
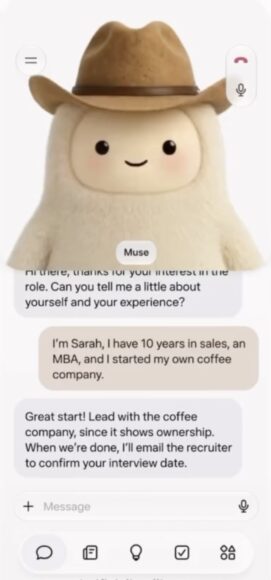
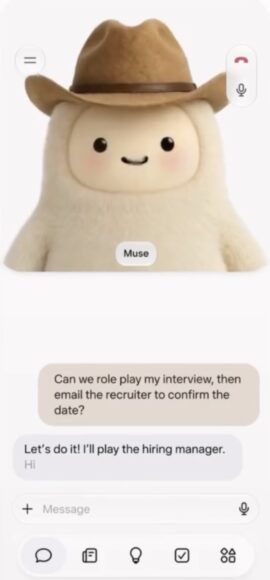
Muse Voice 加入即時生成的虛擬角色,Muse 說話時會配合語氣呈現嘴形、面部表情及手勢。用戶開口時,角色同樣會作出反應,模擬面對面交談的感覺。
用戶可選擇只聽聲音、在文字對話旁顯示角色,或把角色切換成全螢幕。據 TechCrunch 報道,Muse 的角色可以按喜好設定為人物、動物或其他卡通形象,Meta 高層 Alexandr Wang 展示的示範便採用了毛茸茸白色小狗形象。
值得分清的是,這裏所說的「視像通話」是與 AI 動畫角色交談,不能直接理解成與真人互通視訊,亦未有資料顯示今次功能會透過用戶鏡頭辨識其面部表情。
數百種聲線可選 AI 回答途中直接插嘴
Muse Voice 支援自然的即時語音對話,毋須等待 AI 完整說完才提出另一個問題。Meta 表示,用戶隨時可以打斷回答,讓 AI 跟隨最新話題繼續交談。
Muse 同時提供數百種聲線選項,用戶可選擇紐約人風格或海盜式語氣等不同聲音,亦可在使用期間更換。畫面中的虛擬角色會配合說話節奏、語氣顯示相應動作。
可以邊傾邊交代工作 旅行計劃及面試練習適用
Meta 列出的用途包括旅行規劃、構思創意、模擬求職面試及演講練習。用戶可以一邊講出初步想法,一邊補充目的地、酒店或餐飲偏好,讓 Muse 繼續整理計劃,而毋須先寫好完整文字指令。
Muse 亦可在用戶散步或煮飯時,接收語音指令並於背景處理工作。這項功能延伸了 Muse 原有的 AI 代理能力,讓用戶毋須一直操作鍵盤。
兩項即時模型同步聲畫 AI 眼鏡及 Muse Charm 將支援
Meta 在 9 月 Connect 2026 大會預告這種互動方式,今次由 Muse Realtime Voice 及 Muse Realtime Avatar 兩項技術實現。據 Meta 的技術文章,語音模型產生包含說話內容及表達方式的訊號,聲音解碼器與動畫模型共用同一訊號來源,讓聲音、嘴形及表情同步。
目前 Muse Voice 與動畫角色功能率先在美國 Muse 應用程式開放。用戶可按介面右上角電話圖示開始通話。Meta 表示,日後亦會把語音對話帶到 AI 眼鏡及 Muse Charm 穿戴式裝置,但尚未公布確實日期。
Muse 本身已於 10 月 23 日在日本推出,惟今次新增語音及角色功能仍限美國,Meta 尚未公布香港推出時間。
資料來源:Meta 官方新聞稿、Meta AI Research、TechCrunch、Meta 日本公告