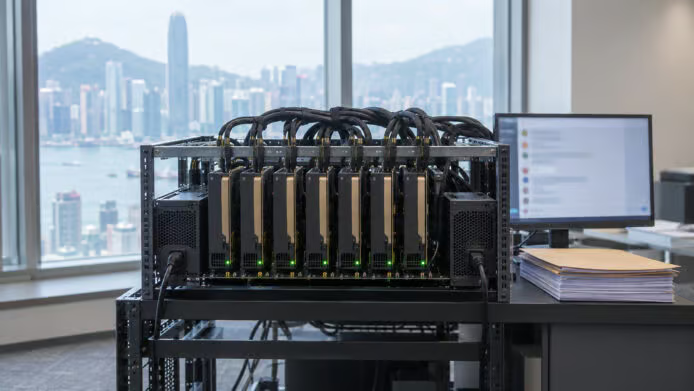
一名律師在 Reddit 分享,用 8 張二手 Nvidia Tesla V100 數據中心顯示卡自建私人 AI 伺服器,讓不能傳上雲端的客戶檔案留在辦公室處理。律師估計,現有約 50–60% 原本交給雲端前沿模型的 AI 工作流程可改由這部伺服器執行,但伺服器暫時每次只能處理一個請求。
8 張 V100 讀檔案摘要及初擬文件
律師的 V100 伺服器每天用來初步處理案件檔案,包括讀取資料夾內的紀錄,抽出事實、日期和數字,再整理摘要及初擬例行文件。律師表示,所有文件送出前都會經真人審閱。
伺服器已接駁檢索資料庫及工具調用功能,用家可在 Windows PC 經 SSH 以類似 Discord 的介面操作。系統運行開源模型 DeepSeek V4.1 Flash,模型大部分壓縮至 2 bit,權重仍佔 248.8GB。
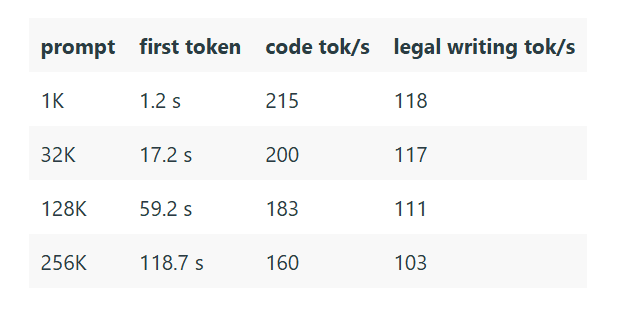
建造者實測,系統撰寫法律文書最快每秒產生 118 個 token,寫程式碼則最快每秒 215 個 token;token 是 AI 處理文字的基本單位。
8 張 V100 分裝在兩塊板上,每塊板內的 4 張卡以 Nvidia 的 GPU 直連技術 NVLink 相連,每塊板合共有 128GB 顯示記憶體;兩塊板之間則靠 PCIe 溝通。主機配備 Gigabyte Threadripper Pro 主機板及 12 核心 3945WX 處理器,兩個電源的總容量為 2,800W,分別接駁辦公室兩條普通電路。
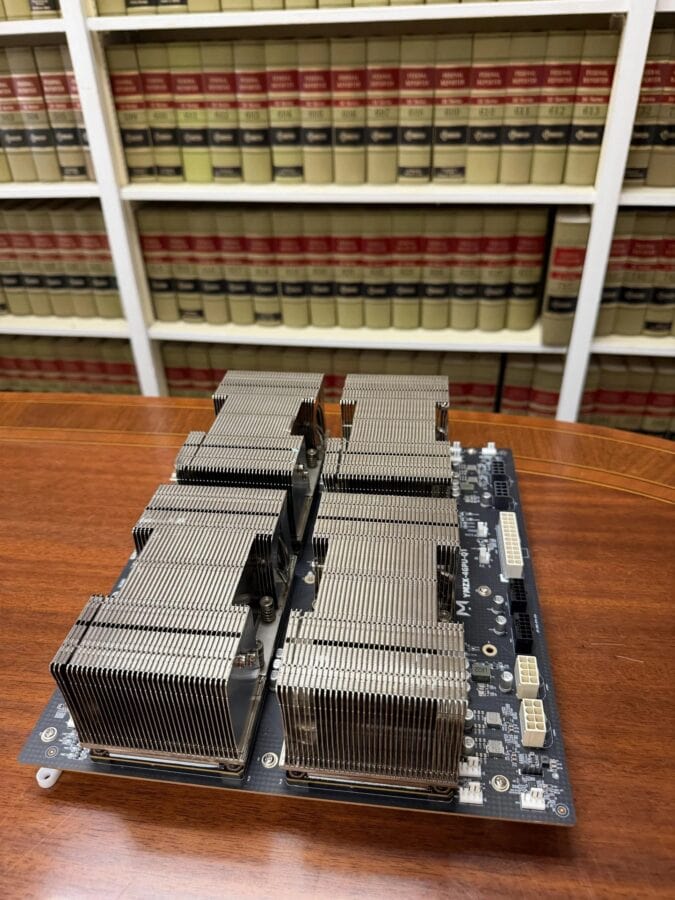
律師買入時每塊 4 卡板約需 2,400 美元(約港幣 HK$18,720),每張卡約 400 美元(約港幣 HK$3,120)。現時 eBay 上二手 V100 單卡叫價約 900 美元(約港幣 HK$7,020),超過當時單卡價格的兩倍。
V100 每次處理一個請求 長提示要等
V100 伺服器現時每次只能處理一個請求。同時處理 2 至 3 個請求的做法已在測試系統驗證,但未放上這部伺服器。
建造者測得系統每秒讀取約 2,200 個 token 的提示。輸入長達 128K token 的提示後,實測要等 59.2 秒才產生第一個 token;256K token 則要等 118.7 秒。系統的上下文上限為 524K token。
PCIe 錯誤曾重啟 V100 驅動只到 R580
V100 伺服器曾兩次因連接其中一塊 GPU 板的 PCIe 致命錯誤自行重啟,兩次都發生在調高功耗上限、GPU 時脈不設上限時。建造者為時脈設上限,並拆走一塊電源接頭有燒焦痕跡的板後,重啟問題才停止;故障原因仍未證實。
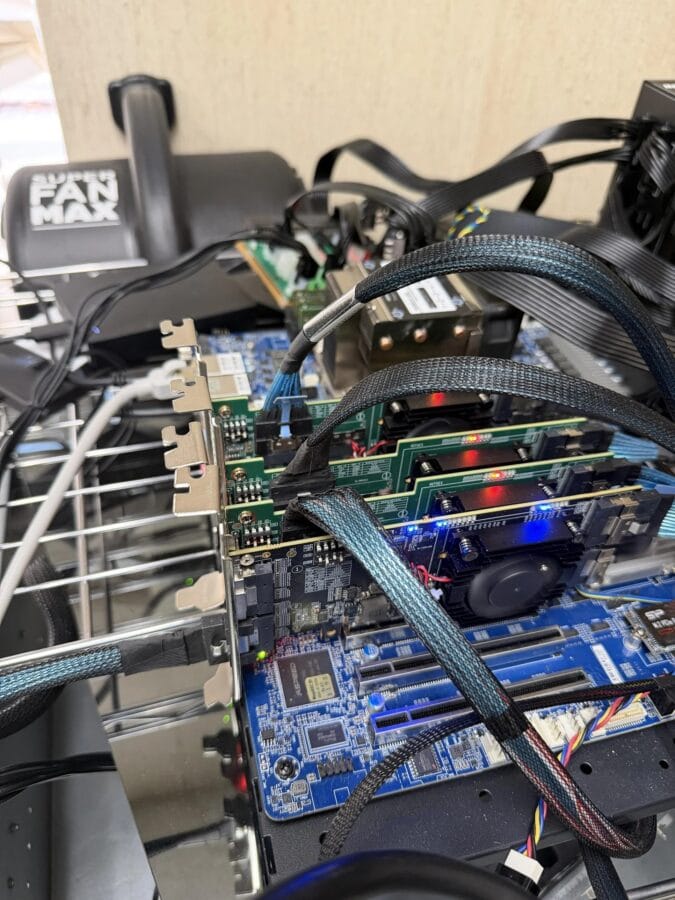
建造者其後將每張卡的功耗上限設為 150W,即額定 300W 的一半,圖形時脈上限則設為 1,522 MHz。建造者測試發現,將功耗上限提高至 200W 並沒有明顯提升效能。
系統記憶體亦曾出現無法自動修正的錯誤,建造者把 RAM 由 DDR4-3200 降至 DDR4-2666 後,問題沒有再出現。
驅動程式支援方面,據報 Nvidia R580 是最後一個支援 V100 所用 Volta 架構的驅動程式分支,CUDA 12.x 亦是 Volta 最後支援的工具套件系列;R580 支援期則據報延至 2028 年中,之後 V100 不會再有新驅動程式可升級。
V100 伺服器目標完全自給自足
律師估計,二手 V100 伺服器可把約 50–60% 原本交給雲端前沿模型的 AI 工作流程留在辦公室處理,但現時仍受每次只處理一個請求、長提示要等、硬件穩定性及驅動支援期限所限。
這部伺服器仍與另一部運行 DeepSeek 的伺服器互相分擔工作,其餘工作流程仍使用前沿模型。建造者表示,系統要完全自給自足才可保護客戶資料,這是建造者的目標,即暫時仍未做到。
建造者認為,這套系統與 API 收費相比似乎較省錢,但速度沒有快多少;律師亦承認目前主要是興趣,將來或可發展成生意。對同樣希望把敏感檔案留在辦公室的人而言,本地部署是一個可參考的做法,但也可能要面對硬件維護和驅動程式支援期限的問題。
來源:Reddit r/homelab、Tom's Hardware