Adobe 在 Adobe MAX 2026 的 Sneaks 環節公布一批 AI 實驗,其中 4 項可把一張相變成可走動探索的 3D 場景、透過視像對話設計 AI 角色並生成動畫「試鏡」片段,以及為影片配聲效和複製修圖步驟。這 4 項仍屬技術預覽,日後可能發展成 Creative Cloud 或 Firefly 的工具,但不保證會推出。
Adobe MAX Sneaks 是甚麼 展示項目未必推出
Adobe MAX Sneaks 是 Adobe 在 MAX 大會上展示研究中新技術的環節,部分項目日後可能發展成 Creative Cloud 或 Firefly 的工具。今屆環節於美國東岸時間 11 月 11 日晚上舉行,即香港時間 11 月 12 日早上 6 時 30 分至 8 時,屬免費的 MAX Online 一部分,可登記網上收看。
同場另外兩項實驗 Deep Brush 及 Hands-On 本週會在重新推出的 Adobe Labs 網站首次公開發布,Adobe Labs 日後亦會開放部分研究預覽讓用戶搶先試用;下文 4 項則暫未有試用安排的消息。
Project Sight Span 一張相變 3D 場景
Project Sight Span 可把一張平面圖片轉成可走動瀏覽的 3D 空間,讓用戶重新選擇構圖及視角。按 Adobe 示範,工具會生成原圖畫框以外的物件和背景,轉身查看背後的環境時亦能自然銜接。
瀏覽 3D 空間時,畫面會較模糊和像素化,選定角度後便會還原解像度。工具適用於相片、畫作及插畫,亦可保留原作風格。
The Verge 記者 Jess Weatherbed 認為,Sight Span 有點像加強版的 Apple Spatial Reframing,可以更大幅度調整構圖,甚至完全改變拍攝位置,但修改後已不太算是一張相。記者亦指出,改變位置後相中人的紋身及五官仍出奇地保持辨識度。
Screen Test 視像對話設計角色 另兩項配聲效及修圖
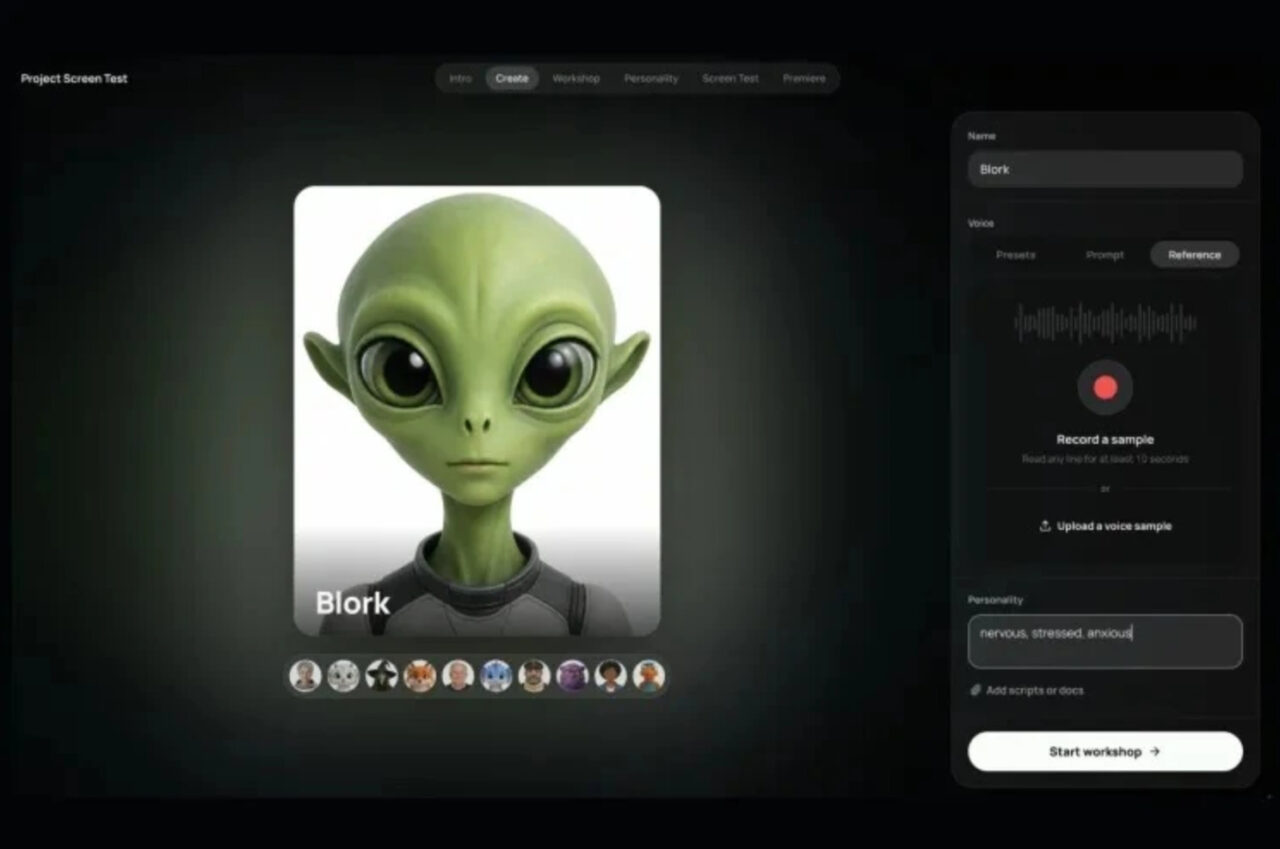
Project Screen Test 讓創作人像進行 FaceTime 視像通話般,透過對話設計 AI 角色。示範中先描述角色的基本性格,例如焦慮、害羞或笨拙,再選擇預設聲音、以文字描述聲線,或上載聲音樣本。
創作人與角色對話時,可補充角色的背景、性格、目標、缺點、恐懼及動作習慣,再描述場景生成動畫「試鏡」片段。Personality 分頁亦可手動調整對話中生成的特質;Screen Test 目前是獨立的創意實驗,未知會否整合進 Adobe 現有 AI 影片工具。
Project Sound Bender 則示範為影片配聲效:上載影片並用文字描述所需聲音(例如「冒泡的科幻煉金鍋聲」)後,系統會生成聲效並自動與影片同步。方形聲音面板的 4 個角分配不同聲效,拖動游標可實時調整哪種聲音較突出,亦可自訂各角的聲效。
Project Rinse Repeat 以 Photoshop 為基礎,可複製已完成的修圖步驟,自動套用到同一張相中的其他人物或物件。例如替合照中一人去除暗瘡後,可把步驟套用到其他人;由於工具用 Photoshop 原生工具重新建立這些修改,套用後仍可完全編輯。
Adobe 4 項 AI 實驗未必推出 科學家稱助精準控制
Adobe 展示的 4 項 AI 實驗涵蓋相片視角、角色設計、影片聲效及 Photoshop 修圖,目前仍是技術預覽,將來可能成為 Creative Cloud 或 Firefly 的工具,但不保證推出。
負責影片及音訊研究的 Adobe 資深首席科學家 Gautham Mysore 表示,令互動更直觀,也是希望讓有經驗的創作人更精準地控制作品;Sound Bender 的聲音調整及 Sight Span 的視角選擇,正是示範中的例子。
來源:Adobe Blog、The Verge、No Film School、CNET